
El fin de las depuraciones a ciegas mediante Trazabilidad Nominal
Introducción
¿Tu infraestructura está en verde, pero un usuario no puede completar su compra? Ese es exactamente el problema que la observabilidad tradicional no llega a resolver.
Un backend respondiendo con HTTP200 puede convivir perfectamente con una interfaz bloqueada o un error de renderizado en la web. Y si una parte de la lógica de tu aplicación se ejecuta en el cliente, monitorizar solo el servidor es quedarte a medias.
En Datadope resolvemos esto con User Experience Monitoring (UEM) basado en OpenTelemetry y el estándar W3C Baggage. La idea es simple: extender la trazabilidad hasta el navegador para saber exactamente qué le pasó a cada usuario. Con ello obtendréis:
- Observabilidad Nominal: Cada traza vinculada a un usuario real, no a una IP.
- Reducción del tiempo de resolución de incidencias (MTTR): Trazamos el flujo completo desde el clic en el navegador hasta la consulta en base de datos.
- Correlación Unificada: Core Web Vitals y salud del backend en un único panel.
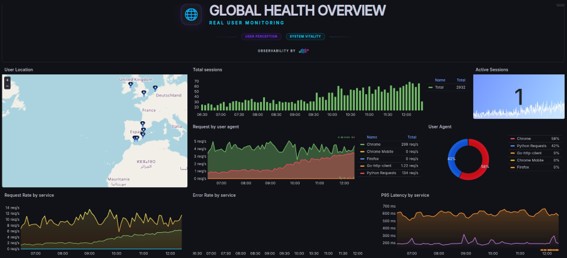
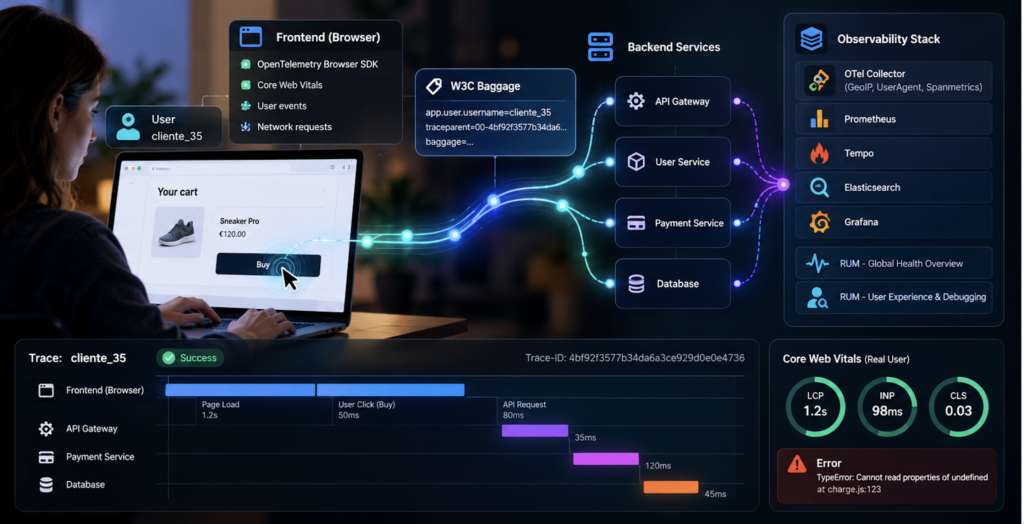
Figura 1: Correlación en tiempo real entre la experiencia de usuario y el rendimiento del backend.
1. El problema de monitorizar solo el servidor
Cuando solo analizas trazas desde el backend, hay tres cosas que se te escapan siempre:
- No sabes quién tuvo el error. Sin metadatos de usuario en el Baggage , correlacionar un fallo con un cliente concreto es prácticamente imposible. Te quedas mirando logs anónimos buscando patrones.
- No ves las latencias reales del cliente. El servidor no puede medir cuánto tarda en renderizarse una página. Una respuesta de API de 50ms no significa nada si el usuario está viendo una pantalla congelada.
- Los errores de frontend directamente no llegan. Los fallos de JavaScript o los errores de red (CORS, timeouts) no aparecen en los logs del servidor. Sin esos datos, un RCA completo es imposible.
La solución: el traceparent tiene que originarse en el navegador. Solo así tienes la foto completa.
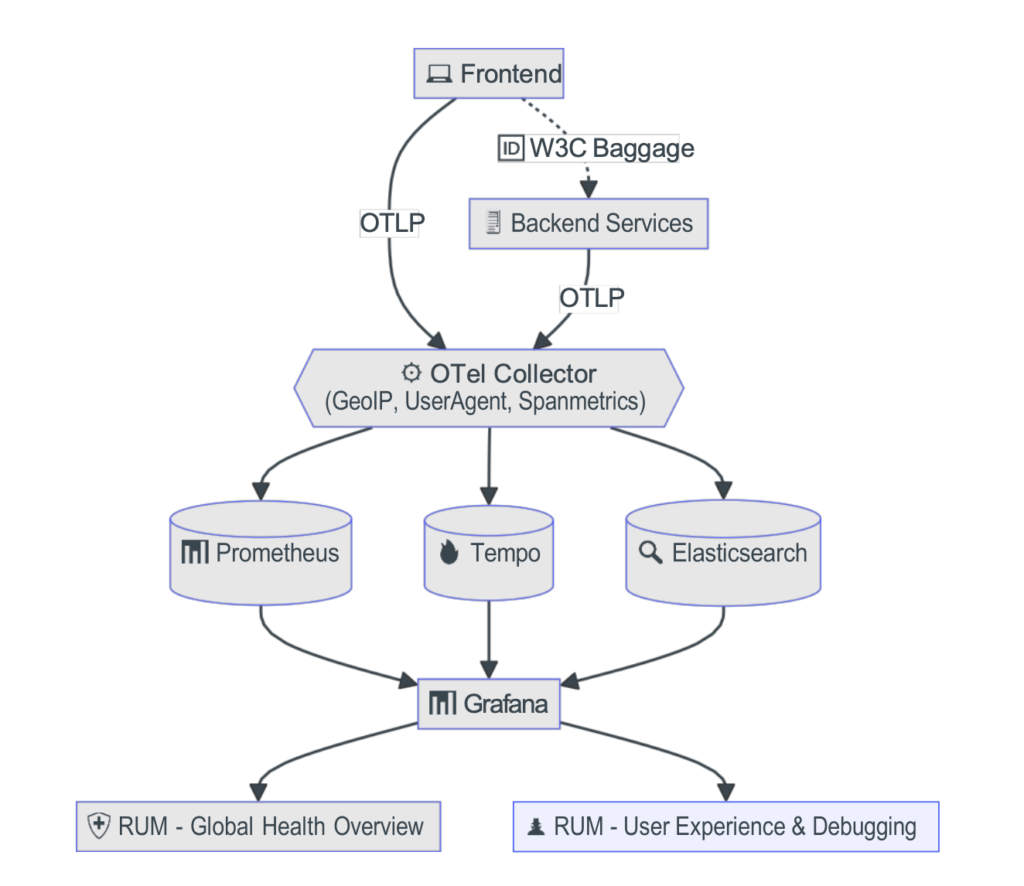
2. Arquitectura: el stack completo
El objetivo es conectar lo que experimenta el usuario en su pantalla con lo que pasa en los servicios de backend, eliminando los silos entre Frontend, Backend y SRE.
Los componentes:
- OpenTelemetry Browser SDK: Instrumenta la aplicación en el cliente y captura eventos web, Core Web Vitals y peticiones de red.
- W3C Baggage: El estándar fundamental que permite inyectar la identidad del usuario en las cabeceras HTTP.
- Observability Stack (OTel Collector + Prometheus + Elasticsearch + Tempo + Grafana): el OTel Collector procesa y enriquece la telemetría. Prometheus y Tempo gestionan métricas y trazas, Elasticsearch los logs. Grafana lo unifica todo.
3. Implementación: propagar la identidad del usuario
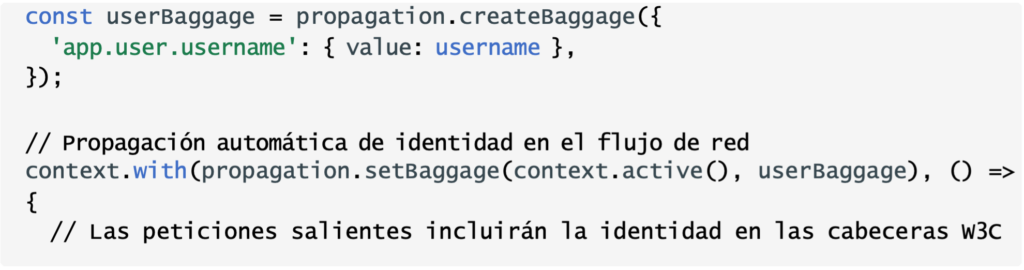
El Baggage de OpenTelemetry es lo que hace posible todo esto. Permite inyectar metadatos en las cabeceras HTTP y que viajen automáticamente por todos los servicios, sin modificar ninguno de ellos.
3.1. Inyección en el cliente
Al inicio de la sesión, inyectamos la identidad del usuario en el contexto activo. A partir de ahí, OpenTelemetry la propaga automáticamente en cada petición saliente.
3.2. Extracción en el backend
Los servicios de backend leen esos atributos del Baggage y los inyectan en sus propios Spans. Resultado: cada traza distribuida lleva la identidad del usuario que la originó, de extremo a extremo.
4. El Impacto Operativo
A. RCA (Root Cause Analysis) en 60 segundos
«cliente_35» pulsa «Comprar» y algo falla. Con trazabilidad nominal, el proceso es directo:
- En Grafana filtras el dashboard completo introduciendo el usuario en la variable.
- Localizas la traza marcada con error y clickas en su Trace-ID.
- Al instante, tienes la vista en cascada de la traza y sus logs correlados y detectas que es un bug de código en la línea 123 del método js.
Sin capturas de pantalla. Sin reproducir pasos. Sin buscar en miles de líneas de logs anónimos.
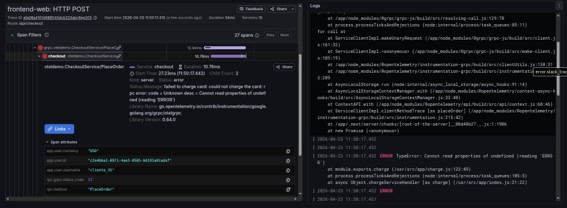
Figura 3 : Detalle de trazabilidad de la sesión de «cliente_35» hasta el error en charge.js.
B. Core Web Vitals reales
Las sondas sintéticas no reflejan lo que experimenta cada usuario en su dispositivo. Con OpenTelemetry, capturamos los Core Web Vitals exactos de cada sesión. Así, puedes distinguir si un problema de rendimiento es tu código
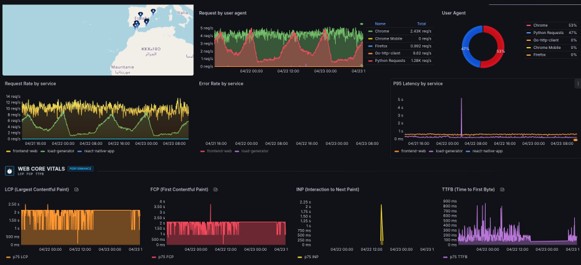
Figura 4: Análisis de Web Core Vitals segmentado por User Agent y localización.
C. Control de cardinalidad
Hay un riesgo real al medir el frontend: si envías URLs dinámicas (ej. /cart/ceckout/8f14-4b…) directamente a Prometheus, el almacenamiento explota.
La solución es normalizar en origen: saneamos las rutas en el cliente ( /cart/checkout/:uuid ) antes de exportarlas como métricas. La URL completa y nominal la guardamos sólo como atributo del Span en Tempo. Así conseguimos visibilidad total, pero sin disparar costes.
5. El impacto en negocio
Más allá de los dashboards, esto tiene un impacto directo en la cuenta de resultados:
- Menos ventas perdidas: Detectas cuellos de botella en el checkout antes de que el impacto en facturación sea serio.
- Soporte más eficiente: El equipo de soporte deja de pedir capturas de pantalla a los usuarios para entender qué pasó.
- Sin vendor lock-in: Al estar basado en el estándar OpenTelemetry no estás atado a ningún backend específico.
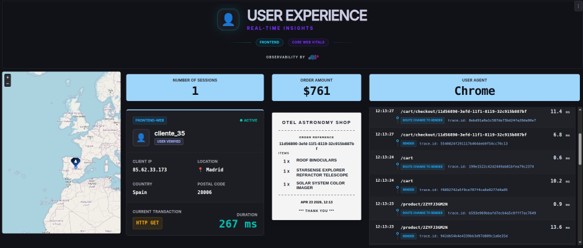
Figura 5: Ficha de la sesión de «cliente_35».
6. Consideraciones a tener en cuenta
- Protege los datos personales: El W3C Baggage viaja en todas las cabeceras HTTP salientes. Si tienes APIs de terceros, tokeniza o hashea los identificadores antes de propagarlos. Además, no envíes información de identificación personal (PII) al backend de observabilidad, mejor usa enmascaramiento a nivel de SDK o un filtrado a nivel de Otel Collector.
- CORS y conectividad: Envía la telemetría a través de un proxy o un endpoint same-origin en lugar de ir directamente al colector. Evitas problemas de CORS y simplificas la configuración de seguridad.
Conclusión
La observabilidad moderna no trata de acumular más logs, sino de pasar del «algo ha fallado para alguien» al «sé exactamente qué le pasó a este usuario, en este momento, en este dispositivo». Con OpenTelemetry extendido hasta el navegador y W3C Baggage propagando la identidad, esa pregunta tiene respuesta en segundos, no en horas.
Si tu equipo todavía depende de capturas de pantalla para depurar errores de frontend, existe una forma mejor de hacerlo.
Si quieres profundizar en los detalles de la observabilidad nominal con OpenTelemetry o tienes dudas sobre cómo implantar User Experience Monitoring en la arquitectura de tu empresa, nos encantará conocer tu opinión. Déjanos tus comentarios en este post, cuéntanos tus impresiones en LinkedIn o escríbenos directamente a través de https://datadope.io/contacto/ para seguir la conversación con el equipo de Datadope.
Alejandro Naranjo Martín

