
Tiempo estimado de lectura: 5 minutos
Introducción
Seguro que te suena esta situación. Tu equipo desplegó varias features durante el mes. Los dashboards estaban en verde. Disponibilidad dentro del SLO, error rates normales, tráfico estable. Nada inusual.
Hasta que llega la factura de tu proveedor cloud.
Un 40% más alta que el mes anterior. No hubo ningún incidente obvio. No saltó ninguna alerta. Y ahora toca pasar la siguiente semana haciendo arqueología en el billing del Cloud de turno intentando entender qué cambió, quién escaló qué, y si ese nuevo servicio que desplegasteis en Kubernetes era realmente tan inocente como parecía.
Esto no es un problema de coste. Es un problema de visibilidad. Y, más concretamente, es el síntoma de que estamos monitorizando sistemas en tiempo real pero gestionando el coste con meses de retraso.
En este post exploraremos cómo integrar la visibilidad de coste directamente en tu plataforma de observabilidad existente, usando OpenCost, billing exports y Grafana, y qué cambia cuando lo consigues:
- Un único panel donde coste cloud real y métricas técnicas conviven y se pueden correlacionar — sin salir de Grafana.
- Democratización del dato: la información de gasto disponible para los equipos técnicos que toman las decisiones, sin necesidad de acceder al portal del proveedor.
- Visibilidad granular en Kubernetes: saber qué servicio o equipo está consumiendo qué porcentaje del gasto del clúster.
- Detección de anomalías de coste en tiempo real, antes de que aparezca en la factura del mes.
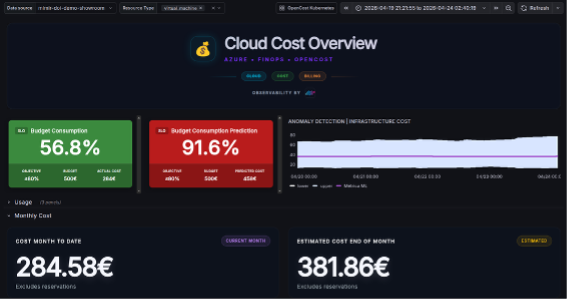
Figura 1: Dashboard Cloud Costs: métricas de costes Cloud.
Dos mundos que raramente se hablan
La observabilidad moderna es bastante buena. Los equipos de plataforma e ingeniería han construido pipelines sofisticados: métricas de CPU y memoria, distributed tracing, logs estructurados, alertas por anomalía. Sabemos si un servicio está degradado antes de que llegue el primer ticket de usuario.
El coste funciona exactamente al revés.
La mayoría de organizaciones se entera de los gastos con un desfase de semanas. El equipo técnico toma decisiones a diario —escala esto, despliega aquello, cambia esta arquitectura— y el equipo de finanzas recibe el extracto a final de mes. Para cuando alguien conecta un aumento de coste con su causa técnica, el contexto ya se ha evaporado.
Nadie recuerda exactamente qué se desplegó el día 12.
Eso es lo que llamamos en la práctica una autopsia financiera: analizar el coste después de que el daño ya está hecho, sin capacidad de correlacionar con los eventos técnicos que lo causaron. Útil para el reporting, pero poco útil para operar.
Y hay algo más estructural: los datos viven en sitios distintos:
- Las métricas técnicas están en Grafana, accesibles para el equipo de ingeniería.
- El coste está en el portal del proveedor cloud, bajo permisos de finanzas, en un formato diseñado para el equipo equivocado.
Para correlacionar ambos mundos hace falta trabajo manual, exportaciones y mucha paciencia.
Kubernetes: el multiplicador silencioso
La situación es ya difícil con infraestructura tradicional. Kubernetes la complica todavía más.
Kubernetes abstrae muy bien la infraestructura. Pero desde el punto de vista financiero introduce la caja negra del coste: el billing del proveedor te dice cuánto cuestan los nodos, pero no te dice qué aplicación, servicio o equipo está consumiendo ese dinero.
Imagina diez servicios distribuidos en un cluster compartido. ¿Cuánto cuesta realmente cada uno? ¿Qué namespace está sobredimensionado? ¿Hay algún equipo que ha triplicado sus recursos este mes sin que nadie lo haya notado?
Con el billing cloud tradicional, esas preguntas no tienen respuesta. Al menos, no sin trabajo manual y no en tiempo real.
Lo que sí existe es una forma de romper esa caja negra: tratar el coste como una señal observable más.
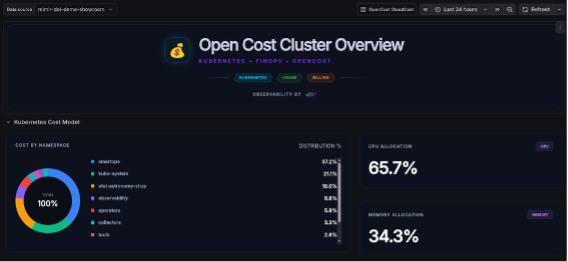
Figura 2: Dashboard Kubernetes Costs: costes Kubernetes separados por namespaces.
Una señal más
Aquí vale la pena dar un paso atrás y cambiar el enfoque…
Cuando un servicio tiene un spike de latencia, no esperamos al final del mes para enterarnos. Tenemos alertas. Tenemos dashboards. Tenemos trazas. El problema se detecta, se correlaciona con su contexto —un deploy, un pico de tráfico, un cambio de configuración— y se actúa.
¿Por qué no funciona igual con el coste?
Latencia, error rate y gasto son señales del mismo sistema. Las tres describen el comportamiento de tu infraestructura y el impacto de tus decisiones técnicas. La diferencia es que las dos primeras ya viven en tu plataforma de observabilidad, y la tercera llega por correo en una factura PDF.
Si la observabilidad es de ingeniería, la responsabilidad del coste también debería serlo. No como una medida de control, sino porque los equipos que entienden el impacto económico de sus decisiones suelen tomar mejores decisiones técnicas.
Tratar el coste como una señal operacional, no como un informe financiero. Esa es la clave.
El stack: cómo funciona
La idea no es construir una nueva plataforma FinOps en paralelo. Es traer el coste al lugar donde ya viven las métricas técnicas: Grafana.
El enfoque une dos fuentes de datos complementarias:
- Cloud billing exports: los exports de facturación del proveedor (Azure, AWS, GCP) con el gasto real.
- OpenCost: calcula, a partir de las métricas de CPU y memoria que ya tienes en Prometheus, cuánto está costando cada namespace, deployment o pod en Kubernetes.
- Capa propia de Datadope: unifica el coste cloud y el de Kubernetes y lo lleva a Prometheus como una métrica más.
- Grafana: destino final, donde el coste convive con el resto de señales técnicas del sistema.
Una vez en Prometheus, los datos de coste real y los de la estimación del uso de Kubernetes conviven en el mismo espacio de métricas:
Cruzarlos con latencia, tráfico o error rate en la misma query. Añadir el coste a un dashboard de SLO existente. Disparar una alerta cuando el gasto de un namespace crece por encima de un umbral que tú defines.
El resultado es que el mismo dashboard donde ves latencia, tráfico y disponibilidad también puede mostrarte cuánto costó ayer, si estás en tendencia de superar el presupuesto del mes, y qué servicio de Kubernetes es responsable del 60% del gasto.
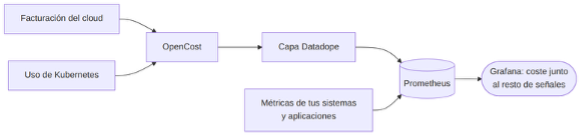
Figura 3: Arquitectura del stack.
Qué cambia para los equipos
El cambio no es solo de herramienta. Es de hábito operacional. Tres situaciones donde esto marca la diferencia:
«Si el tráfico sube un 10%, ¿por qué el coste sube un 40%?»
Esta pregunta, antes irresoluble en tiempo real, se convierte en algo investigable en minutos. Puedes superponer en Grafana la evolución del tráfico con la evolución del coste por servicio y tipo de recurso —cómputo, almacenamiento, red —. Si hay una desproporción, se ve.
Y puedes correlacionarlo con los eventos técnicos que ya tienes en tu plataforma de observabilidad:
- Un deploy reciente
- Un cambio de configuración.
- Un aumento de réplicas
El gasto deja de ser un número suelto y pasa a tener una explicación técnica detrás.
Detectar antes de que llegue la factura
El caso que mejor ilustra el valor de esta visibilidad ocurrió durante la puesta en marcha de un nuevo servicio en Kubernetes.
El servicio parecía funcionar correctamente: latencia normal, sin errores, métricas técnicas en verde. Pero a los pocos días, el dashboard de costes mostraba un crecimiento anómalo en la categoría de almacenamiento — un incremento del 80% en menos de 72 horas. La alerta saltó sobre la métrica de coste, igual que saltaría sobre un spike de latencia.
La investigación fue directa. Correlacionando el timestamp del incremento en Grafana con los eventos de despliegue, se identificó el servicio causante. El diagnóstico: una mala configuración generaba escrituras masivas y repetidas en el almacenamiento cloud — operaciones silenciosas desde el punto de vista técnico, pero con un coste real acumulándose cada segundo.
Sin visibilidad de coste en tiempo real, ese comportamiento habría permanecido invisible durante semanas. Habría aparecido en el extracto de fin de mes como un incremento inexplicable, sin contexto y sin causa raíz obvia.
Con ella, fue un incidente resuelto antes de que llegara la factura.
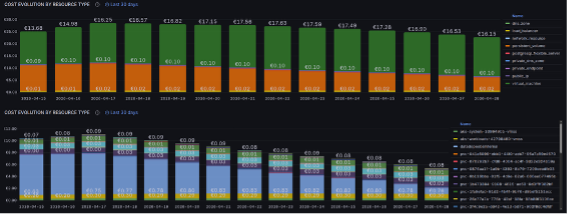
Figura 4: Histórico de coste diario por grupo de recurso y por ID de recurso.
El coste llega a quienes toman las decisiones técnicas
Los datos de billing están en el portal del proveedor, habitualmente bajo permisos que no tienen los ingenieros que toman las decisiones del día a día. Existe una barrera de acceso que desconecta la causa —la decisión técnica— del efecto — el coste.
Cuando el coste vive en Grafana, esa barrera desaparece. El mismo engineer que despliega un servicio puede ver, en el mismo entorno donde trabaja, qué impacto tiene ese servicio en el presupuesto. Sin AWS Cost Explorer. Sin pedir informes al equipo de finanzas.
Si el equipo ve lo que gasta mientras trabaja, la optimización ocurre de forma natural. El coste deja de ser una responsabilidad externa para convertirse en parte del criterio de calidad de cualquier decisión de arquitectura.
Eficiencia, no solo ahorro
Es tentador enmarcar todo esto como una iniciativa de reducción de costes. Pero eso se queda corto.
La observabilidad técnica no existe solo para «reducir incidentes». Existe para operar con confianza y tomar decisiones con datos. La visibilidad financiera tiene exactamente el mismo propósito aplicado al gasto.
Un sistema bien operado cumple tres condiciones: funciona, es eficiente y es sostenible. Las tres deberían ser visibles al mismo tiempo, para los mismos equipos.
De la incertidumbre a la señal
Hay un patrón en la madurez de la observabilidad:
- Primero monitorizamos lo que podemos — logs, uptime.
- Después lo que importa — SLOs, latencia, error budgets.
- Finalmente construimos una cultura donde las decisiones se toman con datos en lugar de intuición.
El coste lleva años fuera de ese ciclo. Sigue siendo un artefacto financiero que se revisa a posteriori.
Integrarlo en la plataforma de observabilidad no es un proyecto de FinOps. Es el paso lógico siguiente en la madurez operacional de cualquier equipo que ya ha invertido en observabilidad técnica. Porque si sabes en tiempo real si tu sistema está degradado, también deberías saber si está siendo eficiente.
Ignacio Castelo González

