
El fin de mantener dos bases de datos. Paso a paso con cómo centralizamos toda nuestra monitorización en ClickHouse gracias a su nuevo tipo JSON. Menos infraestructura, consultas hasta 28x más rápidas y las lecciones que aprendimos en producción.
Introducción y contexto
En una de nuestras plataformas de monitorización, ClickHouse ya era el almacenamiento principal para las métricas que recopilamos a gran escala. Sin embargo, nuestra propia telemetría (estadísticas del sistema operativo, contenedores Docker, métricas de bases de datos, etc.) residía en un stack independiente de Telegraf + InfluxDB (1.8). La razón era sencilla: Telegraf escribe en InfluxDB mediante el protocolo de línea (line protocol) y todo se crea automáticamente. ¿Un nuevo host, un nuevo contenedor, un nuevo campo de un plugin? Simplemente aparece. Sin esquemas, sin migraciones, etc.
Esa comodidad mantuvo viva una segunda base de datos durante años. Pero dos bases de datos implican dos sistemas que parchear, monitorizar, respaldar y dimensionar, además de dos lenguajes de consulta en el mismo Grafana (donde tenemos la mayoría de nuestros paneles y reglas de alerta). Y todo esto mientras el almacenamiento principal de la plataforma, el que ya sabíamos cómo operar y escalar, estaba justo a su lado. Llevábamos mucho tiempo queriendo consolidarlo todo en ClickHouse. Lo que finalmente lo hizo posible fue el tipo de datos JSON nativo de ClickHouse (listo para producción desde la versión 25.3), que ofrece gran parte de esa experiencia de desarrollo sin esquema (schemaless) manteniendo por debajo un almacenamiento columnar real.
En este artículo explicamos cómo lo hicimos, los números que obtuvimos y lo que cuesta el tipo JSON en tiempo de fusión (merge time), porque nada sale gratis.
El tipo de datos JSON en ClickHouse
ClickHouse es una base de datos SQL clásica y estrictamente tipada. Cada columna debe declararse con un tipo explícito. Telegraf, por otro lado, emite docenas de mediciones con cientos de campos, y ese conjunto cambia cada vez que alguien habilita un plugin.
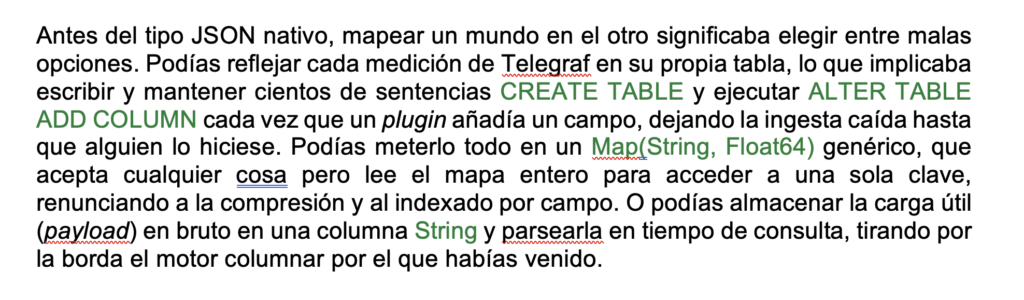
El tipo JSON resuelve ese dilema. La tabla declara una columna JSON y no necesita más; ClickHouse infiere los campos a partir de los propios datos y los almacena internamente como columnas reales. Obtienes la ergonomía de InfluxDB de «simplemente envíalo» en la ruta de escritura y el rendimiento estricto de SQL en la ruta de lectura.
La nueva solución
Telegraf sigue haciendo lo mismo, pero en lugar de escribir en InfluxDB, publica JSON en Redpanda (que es básicamente como Apache Kafka, para quienes no lo conozcan). ClickHouse lo consume mediante una tabla con motor Kafka (Kafka engine) y un par de vistas materializadas:
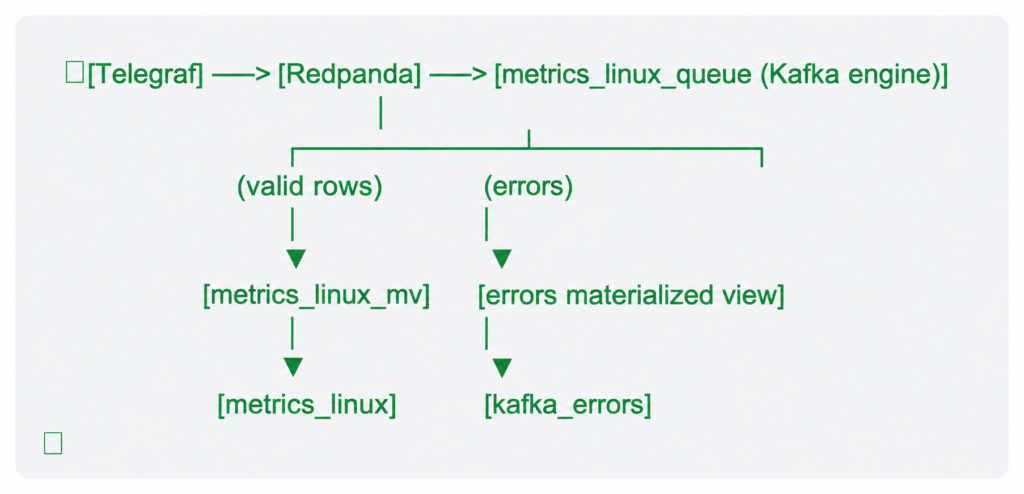
La tabla con motor Kafka utiliza kafka_handle_error_mode = ‘stream’, de modo que una carga útil (payload) malformada no bloquea al consumidor: Las filas válidas fluyen hacia la tabla de almacenamiento, mientras que las defectuosas van a parar a una tabla de mensajes no entregados (dead-letter) junto con el mensaje en bruto y el error de parseo adjunto. El offset del consumidor siempre avanza.
La tabla de destino es donde reside la parte interesante:
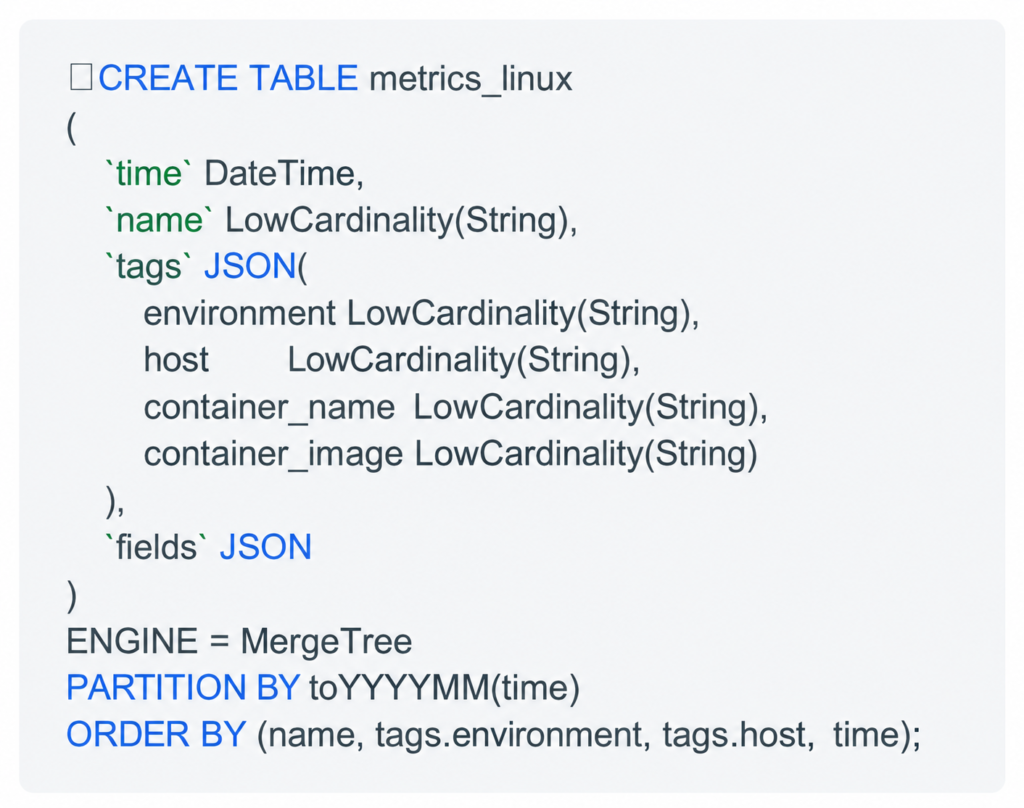
name contiene lo que solía ser la medición (measurement) de InfluxDB (cpu, disk, docker_container_mem, …). Las etiquetas (tags) y los campos (fields) van a parar a dos columnas JSON. Cuando mañana un plugin de Telegraf empiece a emitir un nuevo campo, este llegará directamente a fields sin que nadie tenga que ejecutar un ALTER TABLE. De eso se trataba precisamente.
El tipo JSON
Una columna JSON en ClickHouse no es un blob de cadena (string). En la inserción, ClickHouse analiza cada ruta (fields.usage_user, tags.host, …) y la almacena como una subcolumna real, tipada y comprimida individualmente dentro de la parte de datos (data part). Consultar fields.usage_user solo lee esa subcolumna. Por lo tanto, cuenta con la misma mecánica que una columna regular y la misma capacidad para usarse en la clave primaria, tal como hacemos con tags.environment y tags.host en el ORDER BY.
Vale la pena conocer tres cosas más allá del titular:
- No todo tiene por qué ser dinámico. Puedes proporcionar pistas de tipo (type hints) para las rutas que sabes que siempre estarán ahí, como hacemos con environment, host y las etiquetas de los contenedores. Las rutas con pistas omiten por completo la inferencia de tipos y se almacenan exactamente con ese tipo. El consejo de la propia documentación es dar pistas sobre tantas rutas como sea posible; la inferencia dinámica es la alternativa (fallback) para lo que no se puede predecir, no el modo por defecto para todo. También existen cláusulas SKIP y SKIP REGEXP para descartar rutas que nunca vas a consultar.
- Existe un límite en las rutas dinámicas, y es de 1024 por defecto. Cada columna JSON almacena como máximo max_dynamic_paths (1024 por defecto) rutas como subcolumnas reales por cada parte de datos (data part). Las rutas que superan ese límite terminan en una estructura de datos compartida (básicamente un Map(String, String)) que sigue siendo consultable, pero es más lenta de leer, ya que extraer una ruta puede implicar escanear el mapa. Durante las fusiones (merges), si las partes combinadas superan el límite, ClickHouse conserva las rutas que se rellenan con más frecuencia como subcolumnas y degrada las más raras a la estructura compartida. Puedes aumentar el parámetro, pero la recomendación oficial es actuar con cautela: los valores altos hacen que el almacenamiento y las lecturas sean menos eficientes, con un límite sugerido de unos 10.000 para discos locales y el valor predeterminado de 1024 para almacenamiento remoto.
Este límite condicionó el diseño de nuestras tablas. En lugar de una tabla de métricas gigante que absorbiera todos los dominios, creamos una tabla por dominio: metrics_linux, metrics_redpanda, metrics_postgres, metrics_grafana, etc. Solo nuestros brokers de Redpanda exponen cientos de nombres de métricas distintos; mezclar los campos de todos los dominios en un único par de columnas JSON es la forma más rápida de superar el límite de rutas y acabar con tus métricas más importantes degradadas a datos compartidos por la última fusión que se haya ejecutado. Las tablas por dominio mantienen el espacio de rutas de cada columna pequeño y predecible, y permiten que cada tabla tenga su propio ORDER BY.
- Las rutas inexistentes se leen como NULL hasta que realizas un cambio de tipo (cast). Una subcolumna dinámica devuelve NULL en las filas donde la ruta no está presente. Pero si la conviertes a un Float64 simple, esos NULL se transforman en 0.0, lo que contamina silenciosamente las agregaciones. Como Telegraf intercala mediciones en la misma tabla, esto supone un problema inmediato: avg(fields.load1::Float64) incluye un cero en la media para cada fila que contenga campos de cualquier otra medición. InfluxDB nunca mostró este comportamiento porque sencillamente no tiene el concepto de que el campo exista en esos puntos. La solución consiste en mantener los NULL como anulables (nullable) al realizar las consultas:
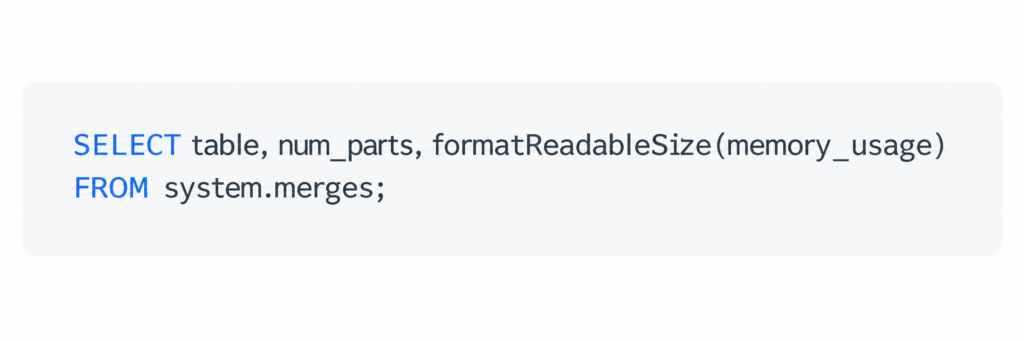
avg ignora los valores NULL, y los números vuelven a coincidir con los de InfluxDB. Filtrar por name (y, cuando sea posible, por un campo que siempre aparezca de forma simultánea con el que estás agregando) permite que estas consultas sigan siendo económicas.
Los números
Una aclaración previa antes de mostrar las tablas, porque preferimos tirar por lo bajo: nuestro InfluxDB era un 1.8 antiguo con años de datos acumulados, ejecutándose junto a otros servicios; nuestro ClickHouse es una versión reciente que también ingiere cargas de trabajo independientes mucho más pesadas. Los periodos de tiempo, el hardware y las cargas de trabajo difieren. Nada de esto es una prueba de rendimiento (benchmark) controlada. Es lo que medimos en nuestro entorno para las métricas de Linux y Redpanda, y las diferencias relativas fueron lo suficientemente grandes como para absorber un margen de error generoso.
Almacenamiento
Medido a partir de system.parts (bytes sin comprimir frente a bytes en disco), en tablas con el tipo JSON:
Dominio de telemetría | Ratio de compresión (en bruto → en disco) |
Métricas de OS y Docker | ~4.8× |
Métricas de brokers de Redpanda | ~58× |
La telemetría de los brokers al estilo Prometheus es brutalmente repetitiva (los mismos conjuntos de etiquetas y contadores que cambian muy despacio una y otra vez), y el almacenamiento columnar junto con las pistas de etiquetas codificadas mediante diccionario convierten esa redundancia en prácticamente nada. Al comparar ventanas de tiempo de la misma duración con respecto a lo que utilizaba InfluxDB para la base de datos equivalente, estimamos aproximadamente entre 3 y 4 veces menos espacio en disco para el dominio de Redpanda. El motor TSM de InfluxDB también comprime; simplemente no llega a aprovechar la localidad a nivel de columna del mismo modo en que lo hace un motor columnar.
Consultas
Dos paneles reales de Grafana en una ventana de 24 horas, con consultas semánticamente equivalentes (la función non_negative_derivative de InfluxQL frente a la función de ventana nonNegativeDerivative de ClickHouse sobre las subcolumnas JSON):
Panel | InfluxDB 1.8 | ClickHouse 25.8 | Aceleración |
Tasa (rate) de un gauge, intervalos de 1 minuto, agrupado por shard | ~200 ms | ~10 ms | ~20× |
Tasa (rate) sobre un contador sumado, intervalos de 2 minutos, agrupado por topic | ~3.4 s | ~0.12 s | ~28× |
El segundo panel es el interesante: Realiza agregaciones a través de muchas series, que es precisamente donde el modelo de almacenamiento por serie de InfluxDB 1.8 resulta caro y donde un escaneo columnar con poda mediante clave primaria (name, tags.environment, tags.host en la clave de ordenación) apenas lo nota.
La letra pequeña: las fusiones de JSON devoran la RAM
ClickHouse escribe las inserciones como partes inmutables y las fusiona continuamente en segundo plano. Para las tablas clásicas con esquema fijo, esto resulta económico. Para las columnas JSON, no es así: una fusión tiene que reconciliar la estructura de subcolumnas dinámicas de cada parte de entrada. Descubre la unión de rutas, reconstruye las columnas por cada ruta y los diccionarios LowCardinality, y decide qué permanece dinámico frente a lo que se desplaza a los datos compartidos.
system.part_log registra el pico de memoria de cada fusión histórica, y el contraste en nuestro clúster es demoledor:
Tabla | Esquema | Pico de RAM observado para una sola fusión |
Tabla típica que contiene otros tipos de métricas en nuestra plataforma de monitorización | Columnas tipadas simples | ~75 MiB (mientras se fusionan~5 GiB de datos en bruto) |
metrics_linux | 2 columnas JSON | ~2.8 GiB |
metrics_redpanda | 2 columnas JSON | ~3.8 GiB |
Por lo tanto, las tablas JSON utilizaron mucha más memoria para fusionar las particiones. Ese es el precio de la flexibilidad de esquema, y es invisible hasta el día en que varias de estas fusiones se ejecutan en paralelo. Para nosotros, ese día llegó cuando empezamos a consumir de un topic de Redpanda con un gran backlog acumulado. Aquí tienes la cadena de acontecimientos, por si te ahorra una tarde de trabajo:
- ClickHouse volcó (flushed) miles de partes diminutas (de cientos de KiB cada una).
- La tabla activó el disyuntor (circuit breaker) de TOO_MANY_PARTS (3000 partes por defecto) y la ingesta se pausó. Todo bien: es la contrapresión (backpressure) funcionando, y los datos esperan de forma segura en Kafka.
- Lo que no estuvo tan bien: el pool en segundo plano (16 hilos por defecto, sobreprogramado al doble por background_merges_mutations_concurrency_ratio) lanzó docenas de fusiones de JSON concurrentes, donde cada una solicitaba desde cientos de MiB hasta varios GiB. En nuestra configuración (un entorno de desarrollo sin tanta memoria asignada), las fusiones aumentaron, alcanzaron el límite de memoria, fueron canceladas (killed), hicieron rollback y se reintentaron. Un bucle de OOM que no avanzaba en absoluto, mientras el OvercommitTracker del gestor de memoria eliminaba consultas SELECT inocentes como daño colateral.
Lo que realmente lo solucionó:
- Limitación de la concurrencia de fusiones: Se dimensionó background_pool_size según las CPU reales y se configuró background_merges_mutations_concurrency_ratio = 1, de modo que la memoria en el peor caso de fusión es simplemente el número de hilos multiplicado por el pico de RAM por fusión: una cifra que puedes presupuestar en lugar de descubrir por las malas. (Si reduces el pool, escala proporcionalmente los ajustes de MergeTree number_of_free_entries_in_pool_to_*, o el servidor se negará a arrancar).
- Margen de memoria real: Dimensionamos los recursos del servidor de ClickHouse basándonos en los datos medidos de part_log. Con las tablas JSON, debemos asegurarnos de tener suficiente memoria, no solo para los casos en los que los datos llegan en un estado estable (steady state), sino también cuando hay grandes acumulaciones (backlogs) de datos por procesar.
Para ayudar a diagnosticar estos problemas, esta consulta resulta útil para ver qué se está fusionando en este preciso momento:
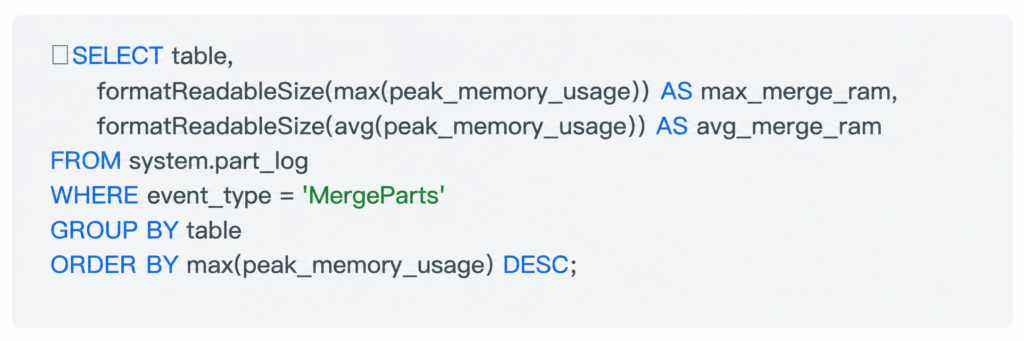
Las versiones recientes de ClickHouse también incorporan merge_max_dynamic_subcolumns_in_wide_part / merge_max_dynamic_subcolumns_in_compact_part para limitar cuántas subcolumnas dinámicas materializan las fusiones.
Conclusiones
El tipo JSON ofrece la experiencia de InfluxDB/Telegraf sobre un motor columnar: los nuevos campos simplemente aparecen y se consultan a la velocidad de una columna nativa. La compresión en datos de telemetría repetitivos está entre muy buena y absurda.
- Proporciona pistas (hints) de todo lo que puedas. Las rutas con pistas de tipo (especialmente las etiquetas LowCardinality utilizadas en la clave de ordenación) son de donde proceden la mayoría de las ganancias de almacenamiento y consulta. Si siempre se reciben determinados campos, simplemente añádeles la pista en el tipo JSON.
- Respeta el presupuesto de ~1024 rutas dinámicas por columna JSON. Acota las tablas por dominio en lugar de aumentar el límite; las rutas que se desplazan a los datos compartidos siguen funcionando, pero de forma más lenta, y las fusiones (merges) deciden cuáles se desplazan.
- Vigila la semántica de la conversión (cast) de NULL frente a cero en campos dispersos, o tus medias te mentirán.
- Presupuesta memoria para las fusiones, no sólo para las consultas. Una tabla con un uso intensivo de JSON puede necesitar gigabytes para una sola fusión en segundo plano que una tabla con esquema fijo resolvería con decenas de megabytes. Mídelo en part_log, limita la concurrencia y mantén grandes las partes de la ingesta.
Para añadir una última nota de honestidad, comparamos un ClickHouse actual con un InfluxDB 1.8 que estaba varias versiones principales por detrás. La diferencia seguramente sería menor frente a un InfluxDB moderno. Pero este ejercicio no va solo de rendimiento. También se trataba de tener una base de datos menos, un único lenguaje de consulta para todo y todo ello sin renunciar a la flexibilidad de esquema.
¿Este artículo te ha hecho replantearte la eficiencia de tu propia arquitectura de métricas? Sabemos que cada infraestructura es un mundo y que la «letra pequeña» importa. Si tienes alguna duda sobre lo expuesto en este post, o si necesitas asesoramiento especializado para escalar, optimizar o unificar tus plataformas de datos no dudes en contactar con nosotros a través de LinkedIn o en https://datadope.io/contacto/
Óscar Erades de Quevedo.

